
Os três sinais de um sistema
Depois de colocar um agente de SRE investigando incidentes sozinho, fica uma pergunta anterior sem resposta, de onde vêm os dados que esse agente usa para investigar. A resposta é a camada de observabilidade da aplicação, formada por três sinais complementares, métricas, logs e traces. Este artigo explica os dois serviços que sustentam essa camada na AWS, o Amazon CloudWatch e o AWS X-Ray, e como eles se conectam.
CloudWatch e X-Ray
O Amazon CloudWatch é ativado automaticamente pela maioria dos serviços da AWS assim que eles são criados, e reúne quatro peças, métricas em intervalos de um minuto por padrão ou de um segundo na resolução alta, logs estruturados ou não estruturados, alarmes que disparam ações quando uma métrica cruza um limite, e dashboards que colocam métricas e logs lado a lado na mesma tela.
O AWS X-Ray resolve um problema diferente, o de saber por onde uma requisição específica passou. Cada requisição recebe um Trace ID, propagado no cabeçalho X-Amzn-Trace-Id, e cada serviço que ela atravessa registra um segmento com o tempo gasto, erros e falhas. Para controlar o volume de dados, o X-Ray usa amostragem por padrão, gravando uma requisição por segundo mais 5% do que exceder isso.
ServiceLens e Application Signals
Métricas e logs sozinhos dizem que algo deu errado, mas não necessariamente onde. Traces sozinhos mostram o caminho de uma requisição, mas não o quadro geral do sistema. O CloudWatch ServiceLens e o Application Signals resolvem essa lacuna, correlacionando os três sinais automaticamente. O Application Signals insere o Trace ID e o Span ID direto nos logs da aplicação, então ao abrir um trace no console, os logs relacionados àquele exato trace aparecem logo abaixo, sem precisar caçar por timestamp.
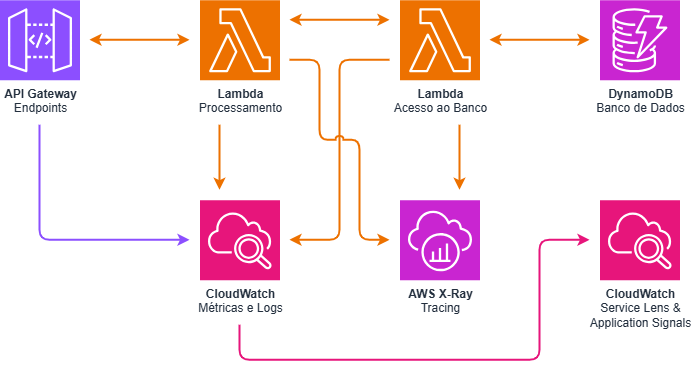
A figura acima mostra uma requisição atravessando o API Gateway, duas funções Lambda e o DynamoDB, com os serviços alimentando o CloudWatch e o X-Ray, que convergem na visão correlacionada do ServiceLens.
O que cada serviço resolve
| O que resolve | O que fica de fora | |
|---|---|---|
| Amazon CloudWatch | Métricas, logs, alarmes e dashboards | Caminho de uma requisição entre serviços |
| AWS X-Ray | Rastreamento distribuído com Trace ID | Armazenamento de métricas e logs |
Quanto custa observar
| Item | Custo | Free tier |
|---|---|---|
| Métricas customizadas | US$ 0,30/métrica/mês nas primeiras 10 mil | 10 métricas grátis |
| Ingestão de logs (Standard) | US$ 0,50/GB | 5 GB grátis/mês |
| Ingestão de logs (Infrequent Access) | US$ 0,25/GB | 5 GB grátis/mês |
| Armazenamento de logs | US$ 0,03/GB/mês | Incluso nos 5 GB grátis |
| Logs Insights (consulta programática) | US$ 0,005/GB escaneado | Consultas via console são grátis |
| X-Ray, traces gravados | US$ 5,00 por milhão | 100 mil grátis/mês |
| X-Ray, traces recuperados | US$ 0,50 por milhão | 1 milhão grátis/mês |
Orientação prática
Para uma aplicação simples, com poucos serviços, o CloudWatch sozinho já cobre a maior parte da necessidade, métricas e logs bem estruturados costumam ser suficientes para entender o que está acontecendo.
O X-Ray se torna essencial a partir do momento em que uma requisição passa por mais de um serviço, como no exemplo do diagrama acima, em que a origem de uma lentidão pode estar em qualquer um dos quatro saltos, e só o rastreamento distribuído mostra qual deles.
O que a prática mostra
A AWS tem um artigo mostrando mais do uso comercial real das ferramentas. A MyTeam11 usa o CloudWatch para gerenciar dinamicamente os recursos de infraestrutura, alcançando 70% de economia mensal em custo de infraestrutura web. Já a GoDaddy usa métricas do CloudWatch para identificar oportunidades de economia, chegando a cerca de 12% de redução de custo em cargas de trabalho simples.
A Thomson Reuters centralizou o monitoramento de 25 mil funcionários com failover automático usando CloudWatch, atendendo requisitos de conformidade e governança de tecnologia da empresa.
Resumo e recomendações
CloudWatch e X-Ray não competem entre si, eles cobrem partes diferentes do mesmo problema, entender o que está acontecendo dentro de um sistema em produção. Quando os dois estão conectados via ServiceLens, a investigação de um incidente deixa de começar do zero, e passa a começar de onde a métrica indicou o problema.
Essa é justamente a camada de dados que sustenta um agente de SRE autônomo, sem métricas, logs e traces bem estruturados, não há o que o agente possa investigar. E como mostramos no artigo sobre LGPD e Segurança na AWS, essa mesma disciplina de instrumentação também ajuda a provar, em caso de incidente, que a infraestrutura estava sendo monitorada como deveria.