
Introdução de Negócio
Um incidente em produção não avisa antes de acontecer, e o tempo entre o primeiro alarme e o entendimento real do problema costuma ser a parte mais cara de qualquer resposta a incidente. Um agente de SRE autônomo na AWS assume boa parte dessa investigação sozinho, do alarme inicial até uma correção pronta para revisão humana.
O que queremos resolver
Manter um ambiente saudável em produção significa reagir rápido quando algo sai do esperado, e a investigação manual tradicional esbarra em alguns limites conhecidos.
Como resolver na AWS
O ciclo começa no próprio ambiente de produção. O AWS CodePipeline publica cada nova versão do sistema na AWS Cloud, e o Amazon CloudWatch acompanha continuamente os logs e alarmes desse ambiente.
Quando uma métrica foge do esperado, o CloudWatch aciona um evento no Amazon EventBridge, que dispara uma função no AWS Lambda. Essa função é o gatilho que chama o AWS DevOps Agent, o agente responsável por investigar o incidente.
O DevOps Agent correlaciona logs, métricas e histórico de deploys para montar uma especificação estruturada do problema e da correção necessária. Essa especificação é entregue ao Amazon Bedrock AgentCore, que atua como o agente de remediação, responsável por transformar o diagnóstico em uma correção concreta.
O AgentCore então abre um pull request no GitHub com a correção proposta, para aprovação manual de um responsável antes de qualquer mudança ir para produção. Depois de aprovado, o próprio CodePipeline publica a correção, fechando o ciclo entre detectar, investigar, corrigir e reimplantar.
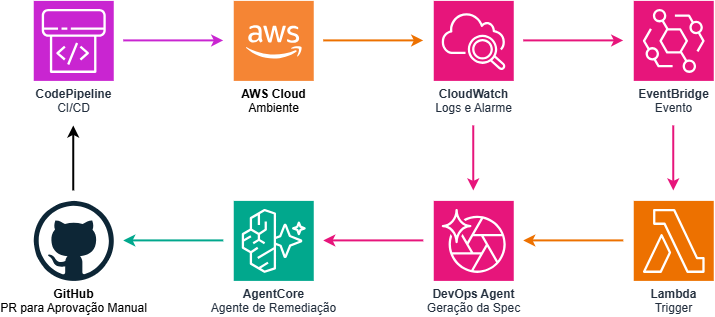
A figura acima mostra o ciclo completo, do alarme disparado no CloudWatch até a correção aprovada e publicada de volta pelo CodePipeline.
Esse fluxo mantém um humano no controle da decisão final, mas remove praticamente todo o trabalho manual de investigação, que normalmente é a parte mais demorada de resolver um incidente.
Ganhos que a arquitetura traz
Investigação automática de ponta a ponta: o agente correlaciona logs, métricas e alarmes sozinho, sem que um engenheiro precise abrir dashboard por dashboard.
Aprovação humana antes de qualquer mudança: a correção só é aplicada em produção depois que alguém revisa e aprova o pull request gerado.
Reaproveita o CI/CD que a empresa já tem: o CodePipeline continua sendo o canal oficial de publicação, o agente só entra no meio do processo.
Aprendizado contínuo: o AgentCore mantém memória de incidentes anteriores, o que refina a qualidade da investigação ao longo do tempo.
Menos fadiga para o time de plantão: alertas viram diagnósticos prontos, não mais uma lista de logs para vasculhar de madrugada.
Casos na literatura
Um workshop oficial da AWS sobre esse tema documenta uma redução de 84% no tempo médio de resolução quando o agente atua de forma proativa, e um resultado geral de cerca de 90% de redução no MTTR, caindo de 50 a 75 minutos de investigação manual para aproximadamente 4 minutos de forma autônoma.
Na prática, o Banco Bmg já investiga mais de 350 incidentes de produção por dia com o AWS DevOps Agent, e reduziu em 87% o tempo de login do aplicativo mobile. A Habby cortou o MTTR de 2 horas para 20 minutos, uma queda de 80%, e a Audible chega a uma resolução mediana de 8,5 minutos, 81% mais rápido que investigações feitas só por humanos.
Lições aprendidas
Um agente de SRE autônomo não substitui o time de operação, ele remove a parte mais lenta do trabalho, que é juntar informação espalhada em várias ferramentas para entender o que está acontecendo.
Com CloudWatch, EventBridge, Lambda, DevOps Agent e AgentCore compondo esse ciclo, a decisão final continua sendo humana, mas o tempo até chegar nela cai de dezenas de minutos para poucos minutos.